在AI时代,我们在或多或少的听过或者见过一些AI相关的词汇。刷AI资讯、用AI工具时,总被一堆专业术语绕晕,Transformer、LLM、RAG、Agent……明明每个字都认识,连起来却像看“天书”?本篇文章就来揭开这些术语的神秘面纱。
Transformer #
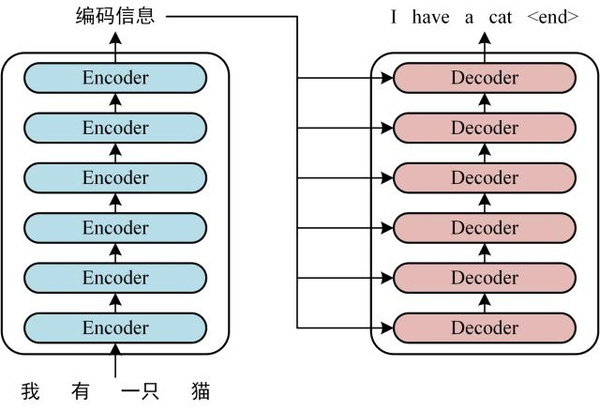
AI界的“底层建筑”,相当于所有现代大模型的“骨架”。最初由 Vaswani 等人在 2017 年的论文《Attention is All You Need》中提出。
通俗说:就像盖房子的“钢筋水泥”,ChatGPT、文心一言、字节跳动豆包等所有主流大模型,都是在Transformer的基础上搭建起来的。它的核心优势是“并行计算”,能同时处理海量信息,还能通过自注意力机制,精准捕捉文本、图像中的上下文关联,让AI理解更全面、反应更快。
Transformer 彻底改变了自然语言处理(NLP)领域,并逐渐扩展到计算机视觉(CV)等领域。
Transformer 的核心思想是完全摒弃传统的循环神经网络(RNN)结构,仅依赖注意力机制来处理序列数据,从而实现更高的并行性和更快的训练速度。
LLM(大语言模型) #
全称Large Language Model,直译就是“大语言模型”,也是我们最常接触的AI类型。
通俗说:就是“会说话、会思考的AI大脑”,比如豆包、ChatGPT,核心能力是理解人类语言、生成文本、回答问题,还能完成代码、文案等创作。它的“大”,体现在训练数据海量、参数量庞大,能覆盖各行各业的知识,相当于一个“行走的百科全书”。
大语言模型(LLM)通常指包含数百亿(或更多)参数的语言模型,它们往往在数万亿(T)token的语料上通过多卡分布式集群进行预训练。这些模型具备远超出传统预训练模型的文本理解与生成能力。广义上的LLM参数量可从十亿(如Qwen-1.5B)到千亿(如Grok-314B)不等,核心判断标准是模型是否展现出涌现能力。
Prompt #
你和AI沟通的“指令”,也是AI干活的“说明书”,是人类与人工智能沟通的核心桥梁。通俗说:就像你给助理下达的工作要求, Prompt写得越清晰、越具体,AI的输出就越符合你的预期。
在人工智能(AI)领域中,“prompt” 是指向模型提供输入以引导其生成特定输出的文本或指令。它是与模型进行交互时用户提供的文本段落,用于描述用户想要从模型获取的信息、回答、文本等内容。Prompt 的目的是引导模型产生所需的回应,以便更好地控制生成的输出。
对于语言模型,prompt 可以是一个简短的问题、一个完整的段落,或者是一组指令,这取决于用户的需求和场景。在生成文本时,模型会试图理解 prompt 并根据其理解生成相应的响应。
user & system**(对话双角色)**,这两个是Prompt里的核心角色,尤其在多轮对话中至关重要,二者配合才能让AI精准输出:
user(用户):就是你本人,是对话的发起者,负责提出需求、提问、反馈,比如“帮我写一首关于春天的诗”,这就是user的指令。
system(系统):隐藏的“规则制定者”,负责设定AI的行为模式、回答风格、边界限制,相当于给AI“定规矩”。比如设定“你是一位专业营养师,只回答与饮食健康相关的问题,语气简洁通俗”,这就是system指令,会全程约束AI的输出。
Token #
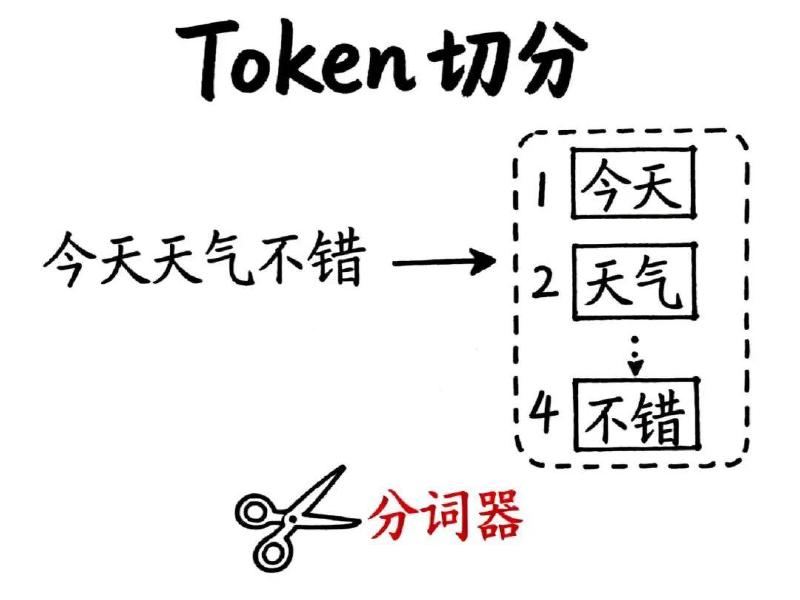
大模型处理信息的最小信息单元,也是AI“计数”的方式,具有智能时代可计量、可定价、可交易的特征——不管是你输入的Prompt,还是AI输出的内容,都会被拆成一个个Token来处理。
通俗说:就像我们说话的“字、词、标点”,但AI的拆分更细致,比如“我爱吃西瓜”,可能会被拆成“我/爱/吃/西瓜”4个Token,标点符号也会算作独立Token。很多AI工具的收费、输出限制,都是按Token来计算的。
国家数据局明确将AI领域的Token定名为“词元”。词元可以是一个汉字、一个标点,亦或是一个词汇片段,用户向AI的每一次提问、AI生成的每一段内容、识别的每一幅图像,本质都是词元的调用与运算。
Context/Context Window #
Context是AI能“记住”的对话内容,Context Window就是AI的“记忆容量”,Context Window 组成部分是 历史会话+当前输入+模型输出。
他们以Token为单位,决定了AI能处理的输入长度和对话连贯性。
通俗说:就像人的“短期记忆”,上下文窗口越大,AI能记住的对话细节越多,越能理解长文本、多轮对话。比如上下文窗口小的AI,聊了10句话就会忘记前面的内容;而大窗口AI,能记住你半小时内的所有提问,甚至能一次性处理几万字的文档。
Tool #
Tool即AI工具,是延伸AI模型能力、实现AI技术落地应用的核心载体,是连接AI模型与实际应用场景的关键桥梁。其并非单一的交互类工具,而是涵盖多专业领域、具备特定功能的模块化组件,每一款AI工具对应一项具体的功能,实现AI模型从“语言交互”到“实际应用”的落地。
AI工具的核心价值在于拓展AI模型的应用边界,常见类型包括搜索工具、代码工具、绘图工具、表格工具等。搜索工具可帮助AI模型获取实时信息与权威数据;代码工具可实现代码生成、程序排查等功能;绘图工具可完成图像创作、视觉设计等任务。借助各类AI工具,AI模型能够突破单一交互功能的局限,广泛应用于职场办公、内容创作、数据分析等多个领域。
RAG(检索增强生成) #
RAG全称为Retrieval-Augmented Generation,即检索增强生成,是当前AI领域解决模型“幻觉问题”(虚假信息生成)的核心技术,其核心逻辑是将“信息检索”与“内容生成”两大功能深度融合,提升AI模型输出的准确性与专业性。
RAG技术的核心流程的是:AI模型在生成输出内容前,先从预设的数据库、官方文档、权威数据源中检索与用户需求相关的真实信息,经过筛选、整理后,基于检索到的权威信息进行内容生成,从根源上避免虚假信息的产生。该技术在医疗、法律、金融等对信息准确性要求极高的领域应用广泛,可确保AI模型输出内容的权威性与严谨性,例如医疗领域可通过RAG技术检索最新医学指南,为临床咨询提供精准支撑。
MCP(模型上下文协议) #
MCP全称为Model Context Protocol,即模型上下文协议,是Anthropic公司于2024年11月发布的开放协议,是AI领域用于统一AI模型与工具连接标准的核心协议,可有效打破不同AI模型与工具之间的兼容性壁垒。
在MCP协议出现之前,不同AI模型与同一工具的适配需单独开发适配代码,存在重复开发、效率低下的问题。MCP协议通过统一连接标准,实现了工具的一次开发、多模型适配,即工具开发者按照MCP协议完成开发后,所有支持该协议的AI模型(包括豆包、ChatGPT、Claude等)均可直接调用该工具,大幅提升了AI工具的适配效率与普及速度。
Agent(智能体) #
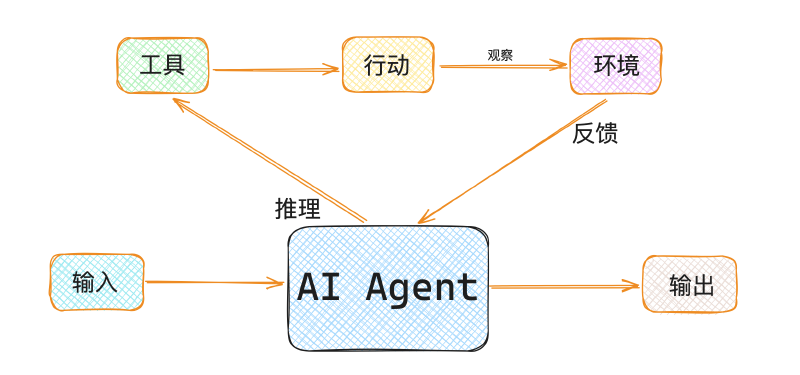
Agent即智能体,是当前AI领域的前沿方向,以大语言模型为核心,整合AI工具与Agent Skill(智能体技能),具备自主理解需求、拆解复杂任务、调度工具、执行落地、复盘优化的全流程能力,区别于普通AI模型的“被动应答”,实现了“主动执行”的核心突破。
Agent的核心优势在于自主化与闭环化,用户仅需提出核心需求,Agent即可自主完成任务拆解、工具调度、结果优化等全流程操作。例如,用户提出“完成本周互联网运营周报并提交至领导”,Agent可自主调取工作数据、梳理工作成果与问题、规范排版,完成周报撰写与提交,无需人类额外干预,大幅提升工作效率。
Agent Skill(智能体技能) #
Agent Skill即智能体技能,是Agent实现任务落地的核心支撑,是区分Agent与普通AI模型、AI工具的关键要素。其与AI工具存在本质区别:AI工具是具备单一功能的模块化组件,而Agent Skill是“工具+使用逻辑+专业经验”的完整封装,是Agent执行具体任务的核心能力单元。
每一项Agent Skill均聚焦于单一具体任务,具备可复用、可组合的特点。例如,“Excel数据汇总”“文案排版”均为独立的Agent Skill,Agent可通过组合不同的技能,完成复杂的全流程任务,如“数据汇总→文案撰写→排版→提交”,实现多任务的高效协同落地。
MOE(混合专家模型) #
MOE全称为Mixture of Experts,即混合专家模型,是一种高效节能的AI模型架构,核心逻辑是“分工协作、专人专岗”,可在控制算力与存储成本的同时,显著提升模型的能力上限,是当前大型AI模型突破性能瓶颈的核心技术之一。
MOE模型由“专家子模型”与“门控网络”两部分组成:专家子模型专注于特定细分领域,每个子模型均具备该领域的专业处理能力;门控网络作为调度核心,负责分析用户需求类型,将需求分配给最适配的专家子模型进行处理,最终整合处理结果输出给用户。这种架构可避免单一模型“多领域兼顾但精度不足”的问题,在提升输出质量与效率的同时,大幅节省算力资源。
模型参数 #
模型参数是AI模型的核心组成部分,是模型训练前未知、训练过程中通过学习海量数据逐步优化得到的可调节数值变量,是模型实现信息推理、内容生成的核心载体,直接决定了模型的能力强弱、泛化能力与输出精度。
模型参数的数量与质量直接影响模型性能:百万级参数模型仅能完成简单的文本分类、基础问答等任务;千万级、亿级参数模型可实现文案创作、代码生成等中等难度任务;千亿级、万亿级参数的大型模型则具备复杂逻辑推理、多语言翻译、专业领域问答等高级能力。需注意的是,模型参数并非越多越好,需与训练数据量、应用场景相匹配,否则会造成算力浪费与参数冗余,影响模型输出效率。
思维链长度 #
思维链长度是指AI模型解决复杂问题时的推理步骤数量,本质上是模型拆解问题、分析推理的完整流程,是衡量AI模型推理能力与严谨性的核心指标。
思维链长度越长,表明AI模型对复杂问题的拆解越细致、推理越严谨,能够处理的问题难度越高,输出结果的准确性与逻辑性越强;反之,思维链长度较短时,AI模型易跳过关键推理步骤,导致输出结果出现偏差或不严谨。例如,在制定半年AI学习计划时,长思维链模型会拆解用户基础、学习目标、时间分配、资料筛选等关键步骤,输出可落地的完整计划;短思维链模型则可能仅罗列学习资料,缺乏系统性与可操作性。
最大输出长度 #
最大输出长度是指AI模型一次可连续生成的内容容量上限,通常以Token为计量单位,是衡量AI模型输出能力的重要指标,与上下文窗口密切相关但存在明确区别:上下文窗口是AI模型可处理的“输入+输出”总容量,而最大输出长度仅针对AI模型的输出内容,不包含用户输入的Prompt。
当AI模型生成内容达到最大输出长度时,会自动停止生成,用户需通过追加指令(如“继续补充”),方可引导模型在原有基础上继续生成内容。这也是部分AI工具生成长篇内容时,需分多次输出的核心原因。
量化 #
量化是AI模型的核心压缩技术,其核心原理是将模型中高精度数值(如32位浮点数,精度高但占用空间大)转换为低精度数值(如8位整数、4位整数,精度略有损耗但占用空间大幅缩减),在最大限度保留模型核心能力的前提下,降低模型的算力消耗与存储成本。
量化技术是AI工具普及至普通设备的关键,通过量化处理,原本需高端服务器支撑的大型AI模型,可在普通电脑、手机、平板等设备上流畅运行,无需依赖专业硬件设备。例如,手机端AI输入法、AI修图工具等,均通过量化技术实现轻量化部署,兼顾使用体验与设备兼容性。
蒸馏 #
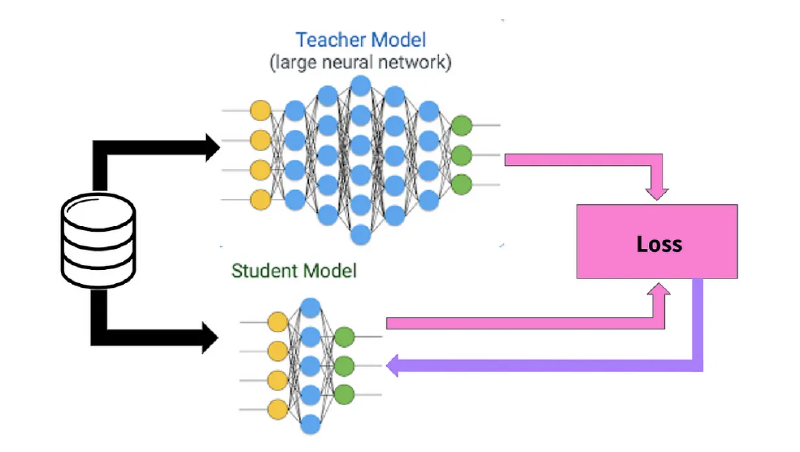
蒸馏即模型蒸馏,是AI模型的核心知识传递技术,核心目标是实现“降本增效”,通过技术手段将大型高性能“教师模型”的知识(推理逻辑、输出规律、专业经验等),传递给小型轻便的“学生模型”,使学生模型在低成本前提下,具备接近教师模型的核心能力。
其中,教师模型通常为千亿级参数的大型模型,能力强但运行成本高、速度慢,适用于专业场景;学生模型为百万级、千万级参数的小型模型,成本低、速度快但能力有限。通过蒸馏技术,学生模型可快速复制教师模型的核心能力,无需从零开始训练,大幅降低AI模型的研发与部署成本,助力中小团队与普通用户获取高性能AI模型。
RL(强化学习) #
RL全称为Reinforcement Learning,即强化学习,是AI模型自主学习的核心方式之一,与监督学习(需人工标注数据)、无监督学习(无需人工标注)并列,核心逻辑是“试错学习、奖惩反馈”,通过不断尝试与反馈调整,优化模型行为,最终找到解决问题的最优方案。
强化学习的核心流程为:AI模型自主尝试处理特定任务,若输出结果符合预期,则获得正向奖励;若结果不符合预期,则受到负向惩罚。通过无数次“尝试-反馈-调整”的循环,模型不断优化行为模式,逐步掌握解决问题的最优方法。目前,AI下棋、自动驾驶、AI游戏角色等场景,均采用强化学习技术完成模型训练。
具身智能 #
具身智能全称为Embodied Artificial Intelligence(EAI),是AI技术与机器人学、传感器技术的交叉前沿领域,与虚拟AI(仅具备语言交互能力,无物理载体)存在本质区别,核心是让智能具备物理身体,通过身体与现实环境的实时交互、感知与学习,形成智能行为与环境适应能力。
具身智能的核心特征是具备物理交互能力,其物理载体包括人形机器人、工业机械臂、智能宠物机器人等,通过摄像头(视觉感知)、声音传感器(听觉感知)、机械臂(动作执行)等组件,实现与现实环境的交互。例如,工业机械臂可完成零件组装,人形机器人可完成家务、老人照料等任务,且能够通过交互不断学习优化行为模式,提升适应能力。